Eine Consent-Architektur, gebaut für unsere Projekte, für Sicherheit und Datensouveränität
Für unsere Webanwendungen haben wir die Verwaltung von Einwilligungen selbst gebaut, statt sie an eine externe Consent-Plattform auszulagern. Funktion, Gestaltung und Verhalten bestimmen wir selbst; Einwilligungen und Protokolle bleiben auf unserer eigenen Infrastruktur – ohne fremdes Script im Ladeweg und ohne laufende Gebühren.
- Art
- Technische Case Study
- Baustein
- @woop-technology/
consent - Referenzprojekte
- Woop Art
- Diese Website
- Status
- Im Einsatz | in laufender Weiterentwicklung
- Integration
- React | Next.js App Router
- Bereitstellung
- Private Paketverwaltung
- Consent-Architektur
- Datensouveränität
- Google Consent Mode v2
- Cookie-Registry
- versionierte Einwilligungen
- Script-Gating
- austauschbare Datenquellen
- Mehrsprachigkeit
- projektspezifische Oberflächen
- serverseitige Protokollierung
Warum wir unser Consent Management selbst entwickelt haben
Webanwendungen binden häufig externe Dienste wie Analytics, Karten, Videos oder Terminbuchungen ein. Damit entstehen zusätzliche Datenflüsse – und zwei Fragen: Unter welchen Bedingungen diese Dienste geladen werden dürfen, und was mit den Daten geschieht, sobald sie den eigenen Server verlassen haben.
Die naheliegende Antwort wäre eine externe Consent-Plattform. Für uns hätte sie drei Dinge mitgebracht, die wir nicht wollten: Eine weitere monatliche Rechnung, ein Consent-System, das nur so weit in die Anwendung reicht, wie der Anbieter es vorsieht – und die Einwilligungsdaten unserer Besucher auf fremden Servern.
Aus diesem Grund haben wir unser eigenes Consent Management entwickelt: Als integralen Bestandteil unserer Anwendungsarchitektur, wiederverwendbar und anpassbar – und so, dass die Daten ausschliesslich auf unserer eigenen Infrastruktur verbleiben.
- 01Einwilligungen und Speicherwerte zentral verwalten, ohne externen Anbieter
- 02Dienste einwilligungsabhängig freischalten
- 03Einwilligungen und Protokolle ausschliesslich auf eigener Infrastruktur verarbeiten
- 04Unterschiedliche Sprachen, Datenquellen und Oberflächen unterstützen
- 05Wiederverwendbar sein, ohne zusätzliche Gebühren pro Monat oder Projekt
Daraus entstand eine eigenständige Consent-Engine, die heute als gemeinsamer technischer Baustein in unseren Projekten eingesetzt wird.
Drei Dinge, die wir nicht aus der Hand geben
Eine externe Consent-Plattform bringt einen zusätzlichen Anbieter mit: Eigene Scripts, eigene Konfiguration, eigene Server und eine laufende Gebühr. Die eigene Engine läuft dagegen zusammen mit der Anwendung, innerhalb derselben Infrastruktur und mit denselben Werkzeugen.
Was das konkret bedeutet, lässt sich an drei Punkten festmachen.
- Kosten
- Keine Lizenz pro Domain, pro Seitenaufruf oder pro Monat. Die Kosten entstehen einmal bei der Entwicklung und laufend in der Pflege.Tragbar wird das, weil derselbe Baustein in mehreren Projekten läuft.
- Kontrolle
- Funktion, Datenbasis, Gestaltung und Verhalten bestimmen wir selbst – bis hinein in den Anwendungscode, der den Consent-Zustand direkt abfragen kann.Nichts endet dort, wo der Funktionsumfang eines Anbieters aufhört.
- Daten
- Konfiguration, Einwilligungen und Protokolle liegen auf unseren eigenen Servern. Kein Dritter speichert, verarbeitet oder sieht die Entscheidungen der Besucher.
Die Consent-Funktion benötigt keine externe CMP
Die Consent-Konfiguration und die zentrale Engine sind Bestandteil der eigenen Anwendung. Für das Consent-System selbst ist deshalb kein externer CMP‑Anbieter erforderlich.
- kein zusätzliches CMP-Script
- kein externer Netzwerkabruf für die Consent-Funktion selbst
- keine fremde Consent-Oberfläche
- keine zusätzliche Plattformabhängigkeit allein für die Verwaltung der Einwilligungen
Zustimmungsabhängige Dienste bleiben davon getrennt und werden erst geladen, wenn die erforderliche Einwilligung vorliegt.
Weniger fremder Code, weniger Angriffsfläche
Ein externes Consent-Script läuft mit denselben Rechten wie die Seite selbst und wird von einem fremden Server nachgeladen. Jede Version, die der Anbieter ausliefert, wird damit Teil der eigenen Website, ohne dass sie sich im Einzelnen prüfen liesse.
Bei etablierten Anbietern ist das in der Regel unproblematisch. Wir ziehen es dennoch vor, den Code zu kennen, der auf unseren Seiten läuft: Die eigene Engine wird wie der übrige Code der Anwendung versioniert, geprüft und ausgeliefert.
- nimmt nur Anfragen von der eigenen Herkunft an
- prüft jede Anfrage auf vollständige und zulässige Felder
- kürzt die IP-Adresse, bevor sie gespeichert wird
- liegt auf einem festen Pfad, für den die vorgelagerte Firewall eigene Regeln führen kann
Einwilligungen und Protokolle liegen auf unseren eigenen Servern
An der Verwaltung der Einwilligungen ist kein weiterer Anbieter beteiligt. Die Entscheidung eines Besuchers wird in der Anwendung wirksam und auf demselben Server protokolliert, auf dem die Anwendung läuft – dort, wo auch die übrigen Daten des Projekts verarbeitet werden. Das gilt für jedes Projekt, das die Engine einsetzt: Die Entscheidungen werden lokal im Container der jeweiligen Anwendung protokolliert.
Welche weiteren externen Dienste ein konkretes Projekt verwendet und welche Daten dabei übertragen werden, wird unabhängig davon projektspezifisch definiert und dokumentiert.
Drei getrennte Ebenen für Logik, Daten und Darstellung
Das Consent-System trennt die zentrale Funktionslogik von den projektspezifischen Daten und der sichtbaren Oberfläche.
Dadurch lässt sich dieselbe technische Grundlage in unterschiedlichen Anwendungen einsetzen, ohne Consent-State, Versionierung oder Script-Gating für jedes Projekt neu implementieren zu müssen.
Der Baustein bringt eine Standard-Oberfläche mit, die das Projekt gestaltet oder ganz ersetzt. So läuft dieselbe Engine auf einer Kunstplattform und auf einem Unternehmensauftritt, obwohl sich die beiden Oberflächen gestalterisch unterscheiden.
- Consent-Engine
- Die zentrale Engine übernimmt die Funktionen, die projektübergreifend gleich bleiben:
- Consent-State
- Versionsprüfung
- Cookie-Registry
- Script-Gating
- Zwei-Klick-Lösungen
- Widerruf
- Bereinigung deklarierter Speicherwerte
- Google Consent Mode v2
- Datenquelle
- Die Engine erhält die projektspezifischen Informationen über eine definierte Schnittstelle. Dazu gehören unter anderem:
- Consent-Version
- Kategorien und Services
- Cookies und weitere Speicherwerte
- Texte je Sprache
- Script-Konfigurationen
- Oberfläche
- Banner und Einstellungsdialog werden für das jeweilige Projekt gestaltet. Die Oberfläche erhält die benötigten Daten und fest definierten Aktionen aus der zentralen Engine.Dadurch lässt sich das visuelle Erscheinungsbild projektspezifisch anpassen, ohne die zugrunde liegende Consent-Logik verändern zu müssen.
Alles auf eigener Infrastruktur.
Die Zahlen unter den Referenzprojekten gelten für deren jeweilige Konfiguration. Kategorien, Services und Cookies sind frei konfigurierbar.
Ein gemeinsamer Baustein statt projektspezifischer Einzellösungen
Die Consent-Engine wird als eigenes Package über die private Paketverwaltung von Woop Technology bereitgestellt. Versionen und Änderungen werden zentral verwaltet; jedes Projekt bindet die Version ein, die es braucht, und übernimmt Updates zu seinem eigenen Zeitpunkt – verschiedene Projekte können deshalb gleichzeitig verschiedene Versionen im Einsatz haben.
Jedes neue Projekt ergänzt vier Bereiche:
- 01Daten
- Kategorien, Services, Speicherwerte und Texte.
- 02Persistenz
- Wo die Protokolle der Consent-Entscheidungen abgelegt werden.
- 03Integrationen
- Analytics und weitere zustimmungsabhängige Dienste.
- 04Design
- Standard-Oberfläche oder individuelle Banner- und Einstellungskomponenten.
Consent-State, Versionierung, Registry, Script-Gating und Widerruf werden aus dem gemeinsamen Baustein übernommen. Verbesserungen an der Engine lassen sich über versionierte Updates in mehrere Projekte übertragen.
Was die Engine mitbringt, was das Projekt bestimmt
- 01Enginekategoriebasierte Einwilligung, Versionierung, Widerruf, Cookie-Bereinigung, Script-Gating, Google Consent Mode v2
- 02ProjektDatenquelle (JSON, API oder Headless CMS), Sprachen, Oberfläche (Standard-UI oder eigene Komponenten), Integrationen (Hooks, Zwei-Klick-Lösungen)
- 03PersistenzConsent-Cookie im Browser, serverseitige Protokollierung, gekürzte IP-Adressen
- 04Stack & BetriebReact, TypeScript, Next.js App Router, Dependency Injection, private Paketverwaltung, geprüfte Eingaben
Zustimmungspflichtige Dienste werden erst nach Einwilligung geladen
Eine zentrale Anforderung bestand darin, zustimmungspflichtige Dienste vor einer Einwilligung nicht lediglich zu deaktivieren. Sie sollen gar nicht erst geladen werden.
Dafür greifen mehrere Mechanismen ineinander.
- Consent Mode startet mit verweigerten Zuständen
- Google Consent Mode v2 wird beim ersten Seitenaufruf mit den entsprechenden verweigerten Speicherzuständen initialisiert. Liegt eine gültige Entscheidung vor oder wird eine Einwilligung erteilt, kann dieser Zustand anschliessend gezielt aktualisiert werden.
- Ohne Einwilligung kein zustimmungspflichtiges Script
- Die Engine stellt nur Integrationen bereit, deren zugehörige Consent-Kategorie tatsächlich akzeptiert wurde. Im Referenzprojekt bedeutet das beispielsweise: Ohne Analytics-Einwilligung wird kein Google-Analytics-Script eingebunden.Die Entscheidung darüber liegt damit nicht verteilt in einzelnen Komponenten, sondern wird zentral über den Consent-Zustand gesteuert.
Die Registry hält technische Nutzung und Dokumentation zusammen
Damit deklarierte Speicherwerte und die tatsächliche Implementierung nicht unabhängig voneinander gepflegt werden, verwendet die Engine eine zentrale Registry. Für jeden über die Consent-Infrastruktur verwalteten Speicherwert werden technische Eigenschaften festgelegt.
- Kennung
- Cookie-Name oder Namensmuster
- zugehöriger Service
- Kategorie
- Speicherdauer
- Speicherart
Sprachabhängige Angaben wie Zweck und Beschreibung werden getrennt davon gepflegt.
Versucht Anwendungscode, über die Consent-Infrastruktur einen nicht registrierten Wert zu schreiben, wird der Vorgang abgelehnt. Damit ist die Registry nicht nur Dokumentation, sondern Teil der technischen Kontrolle.
Consent-Entscheidungen sind an eine Konfigurationsversion gebunden
Jede Consent-Konfiguration besitzt eine Version.
- Consent-ID
- Version der Konfiguration
- Zeitpunkt der Entscheidung
- akzeptierte Kategorien
Bei einem weiteren Besuch vergleicht die Engine die gespeicherte Version mit dem aktuell eingesetzten Stand. Weichen die beiden voneinander ab, verwirft die Engine die gespeicherte Auswahl und holt eine neue Entscheidung ein.
Damit lässt sich beispielsweise ein neu hinzugekommener Dienst über eine neue Consent-Version abbilden, ohne für jede Website eine eigene Migrationslogik zu entwickeln.
Eine geänderte Entscheidung wirkt auch technisch
Eine Einwilligung kann jederzeit über die Consent-Einstellungen angepasst werden. Wird eine zuvor akzeptierte Kategorie wieder abgewählt, wird nicht nur der gespeicherte Consent-Zustand geändert.
- entfernt deklarierte Speicherwerte der abgewählten Kategorie
- aktualisiert den Google Consent Mode
- verhindert, dass zugehörige Dienste erneut geladen werden
- und versetzt die Anwendung bei Bedarf über einen Neuaufbau wieder in einen sauberen Zustand
Der Neuaufbau ist relevant, weil bereits ausgeführte Drittanbieter-Scripts nicht allein durch das Entfernen ihres Script-Elements zuverlässig rückgängig gemacht werden können.
Nach dem Widerruf soll der Zustand deshalb dem eines Besuchers entsprechen, der die betreffende Kategorie nicht freigegeben hat.
Was eine Einwilligung im Browser speichert
Zwei Klicks, bevor ein externer Dienst lädt
Nicht jede Einwilligung gehört ins Banner. Für eingebettete Dienste wie die Terminbuchung holt die Engine sie dort ein, wo der Besucher den Dienst tatsächlich nutzen will.
- 01
Erster Klick: Hinweis
Die Schaltfläche zeigt, welcher Anbieter geladen würde und welche Daten dabei übertragen werden. Ihre Beschriftung wechselt zu „Google Calendar laden“.
- 02
Zweiter Klick: Laden
Erst jetzt werden Script und Stylesheet des Anbieters eingebunden und die Buchung geöffnet. Bis dahin geht keine Anfrage an Google.
- 03
Ohne Umweg über das Banner
Der Besucher muss dafür keine Kategorie in den Consent-Einstellungen freigeben. Die Entscheidung fällt am Dienst selbst, für genau diesen Dienst.
Die Bausteine dafür liegen im selben Package wie die Engine: Fertig für Google Calendar und Calendly, für weitere Dienste über eine gemeinsame Grundkomponente.
Die Consent-ID ist mit einem Klick zur Hand
Jede Entscheidung wird auf dem Server protokolliert, eindeutig auffindbar ist sie aber nur über ihre Consent-ID. Ein eigener Baustein legt sie Besuchern griffbereit hin.
Die ID steht im Consent-Cookie, wo sie ohne Entwicklerwerkzeuge niemand sieht. Trotzdem ist sie der einzige eindeutige Weg zum Eintrag auf dem Server, weil die IP-Adresse nur gekürzt gespeichert wird.
Der Baustein zeigt die ID an und kopiert sie mit einem Klick. Bei einer Frage, einer Beanstandung oder einer Auskunftsanfrage schicken Besucher sie gleich mit, und der Eintrag ist ohne Rückfragen gefunden – mit Zeitpunkt, Version und Auswahl.
Der Baustein steht in der Datenschutzerklärung der jeweiligen Website und führt von dort auch direkt in die Consent-Einstellungen.
Ihre aktuelle Consent-ID
Diese eindeutige ID wird lokal in Ihrem Browser und pseudonymisiert auf unserem Server gespeichert, um Ihre Datenschutzauswahl nachzuweisen. Bei Fragen oder Beschwerden zu Ihrer Einwilligung senden Sie uns diese ID bitte mit – so finden wir den zugehörigen Nachweis eindeutig.
Noch keine Auswahl getroffenDer Baustein kommt vorbereitet im Consent-Package mit. Wie Banner und Einstellungsdialog lässt er sich frei gestalten: Die Funktionsweise bleibt im Package, das Aussehen bestimmt das Projekt – hier das dieser Website.
Die Consent-Logik ist nicht an eine bestimmte Datenquelle gebunden
Die Consent-Engine liest ihre Daten nicht selbst, sondern über eine definierte Schnittstelle. Woher sie stammen, entscheidet die Implementierung dieser Schnittstelle – die Engine bleibt dieselbe.
- Standard: Dateien im Projekt
- Die mitgelieferte Implementierung liest versionierte JSON‑Dateien, die mit dem Quellcode ausgeliefert werden. Für die Konfiguration ist kein Netzwerkabruf nötig.
- Redaktionelles CMS
- Wird die Schnittstelle für ein Headless CMS implementiert, pflegt die Redaktion Texte, Services und Cookies dort – ohne dass die Engine angepasst wird.
- Eigenes System über API
- Ebenso lässt sich ein eigenes CMS oder ein zentraler Dienst über seine API anbinden – etwa um Consent-Daten für mehrere Anwendungen gemeinsam zu pflegen.
Technische Definition und Übersetzungen bleiben getrennt
Cookie-Namen, Kennungen, Kategorien und Speicherdauern werden einmal definiert. Die Texte in Banner und Einstellungsdialog liegen dagegen in jeder Sprache vor; angezeigt wird die Sprache, die der Besucher gewählt hat:
- Kategoriebezeichnungen und Beschreibungen
- Serviceinformationen und Cookie-Zwecke
- Informationen zu Datenübermittlungen
- Bannertexte und Schaltflächen
- Screenreader-Beschriftungen
Eine gemeinsame Logik, unterschiedliche Oberflächen
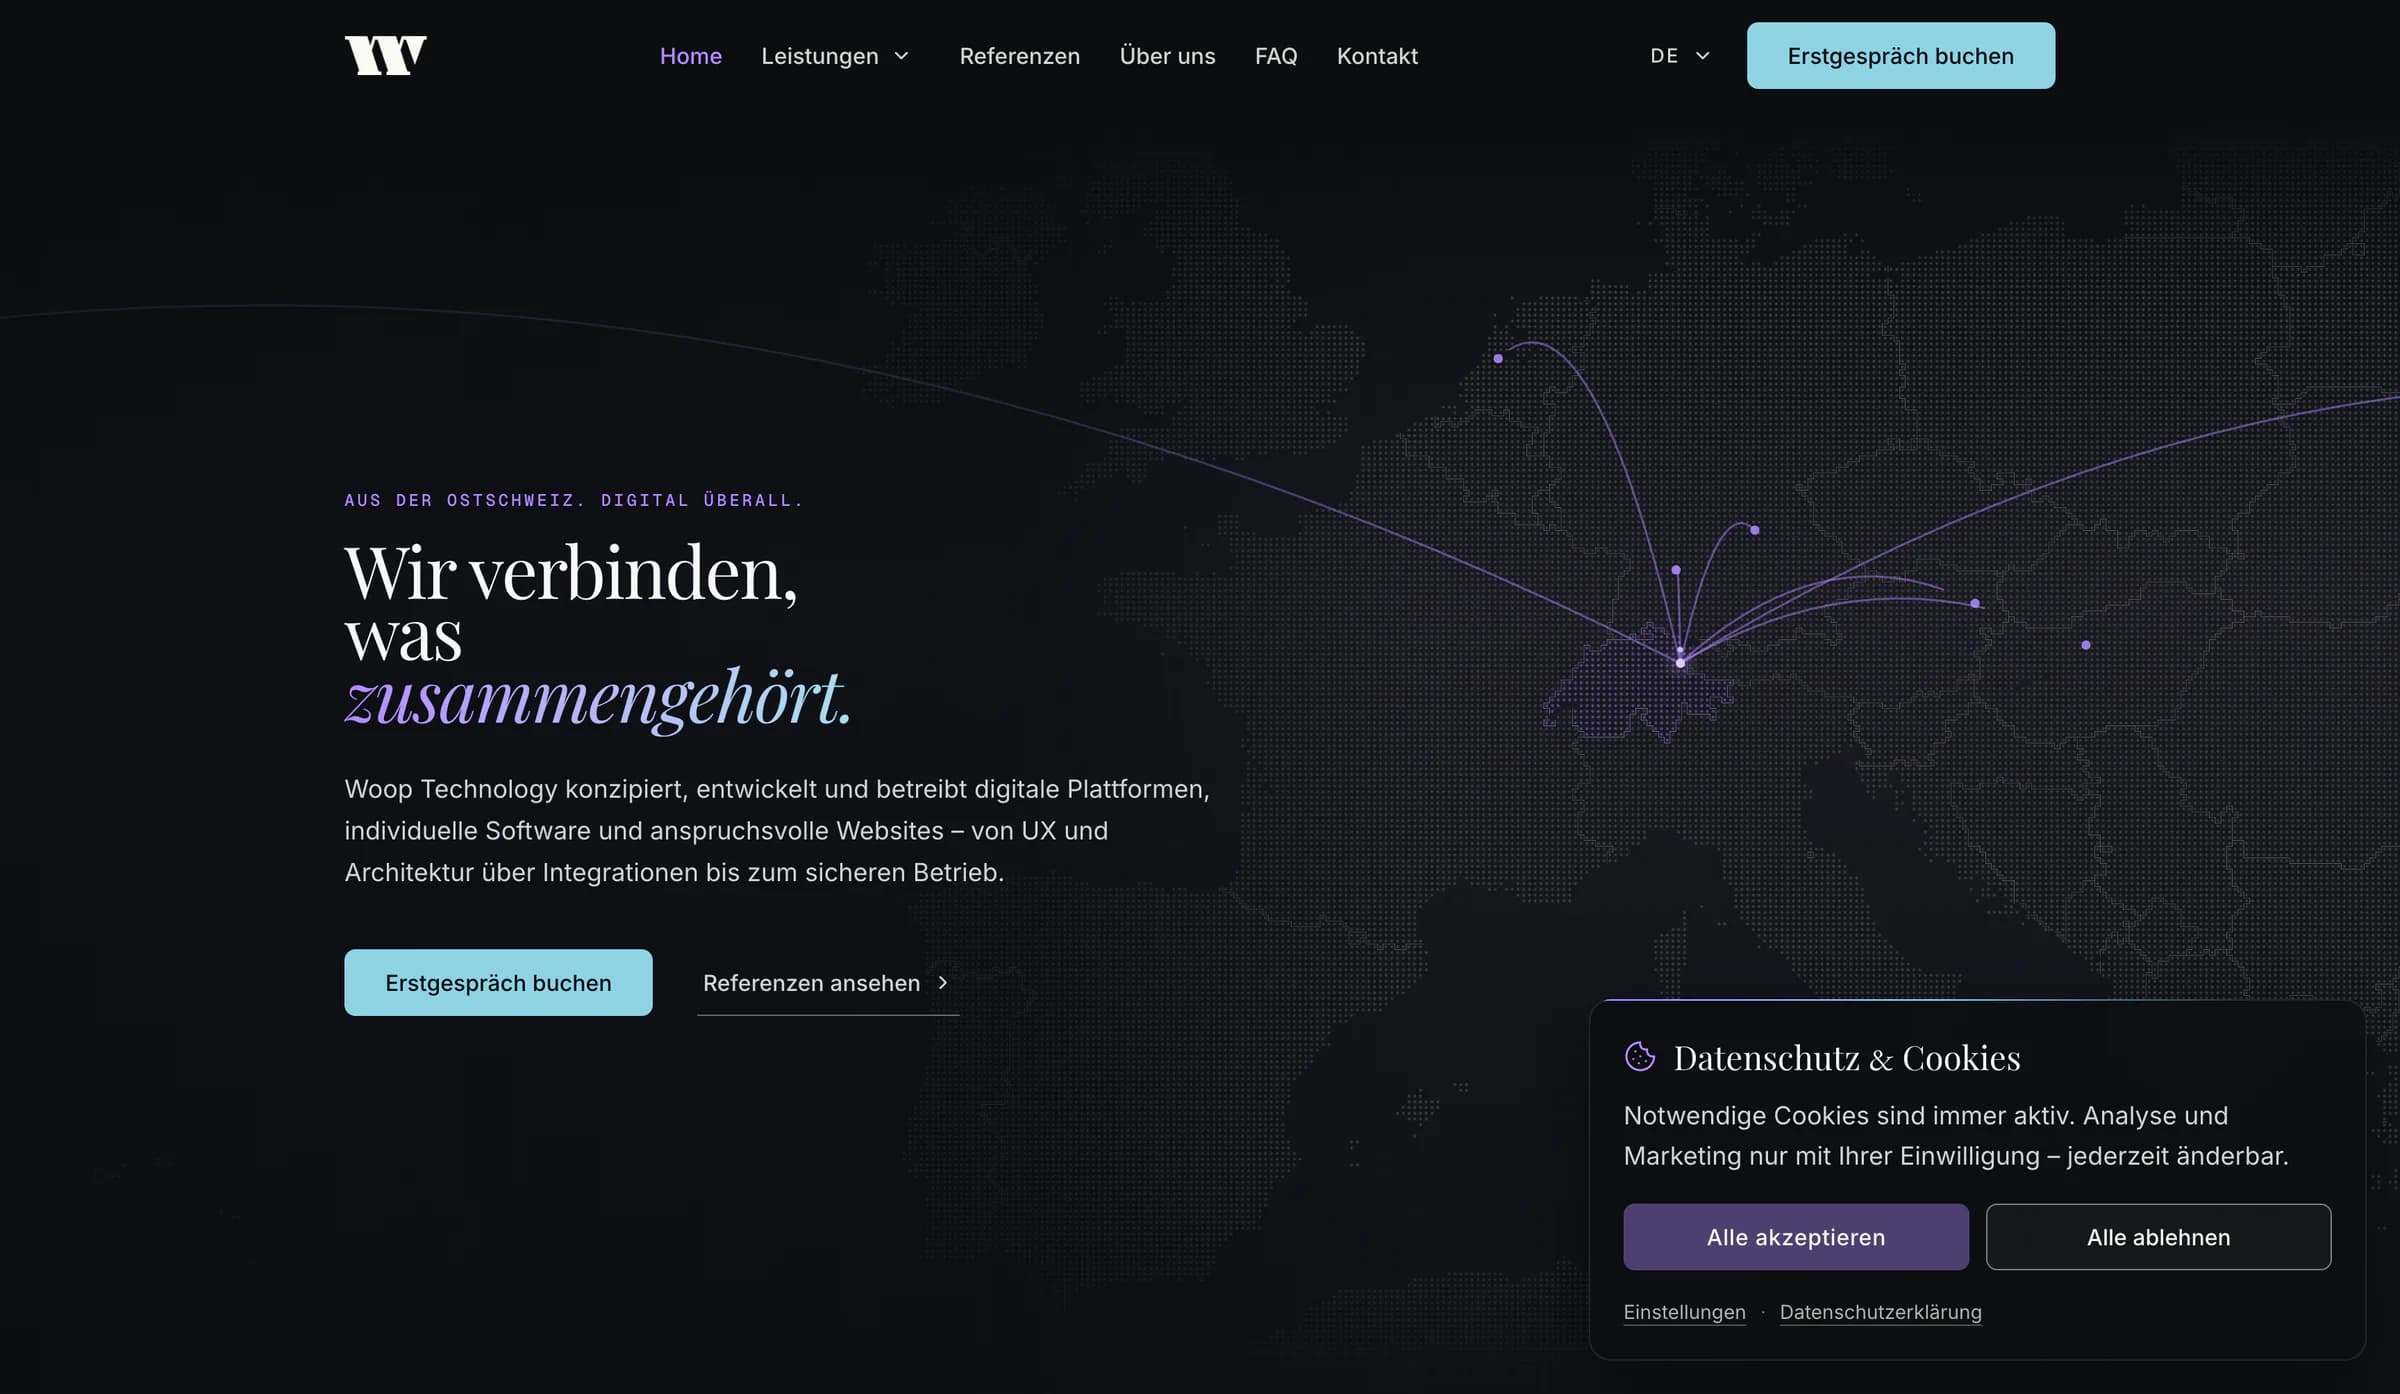
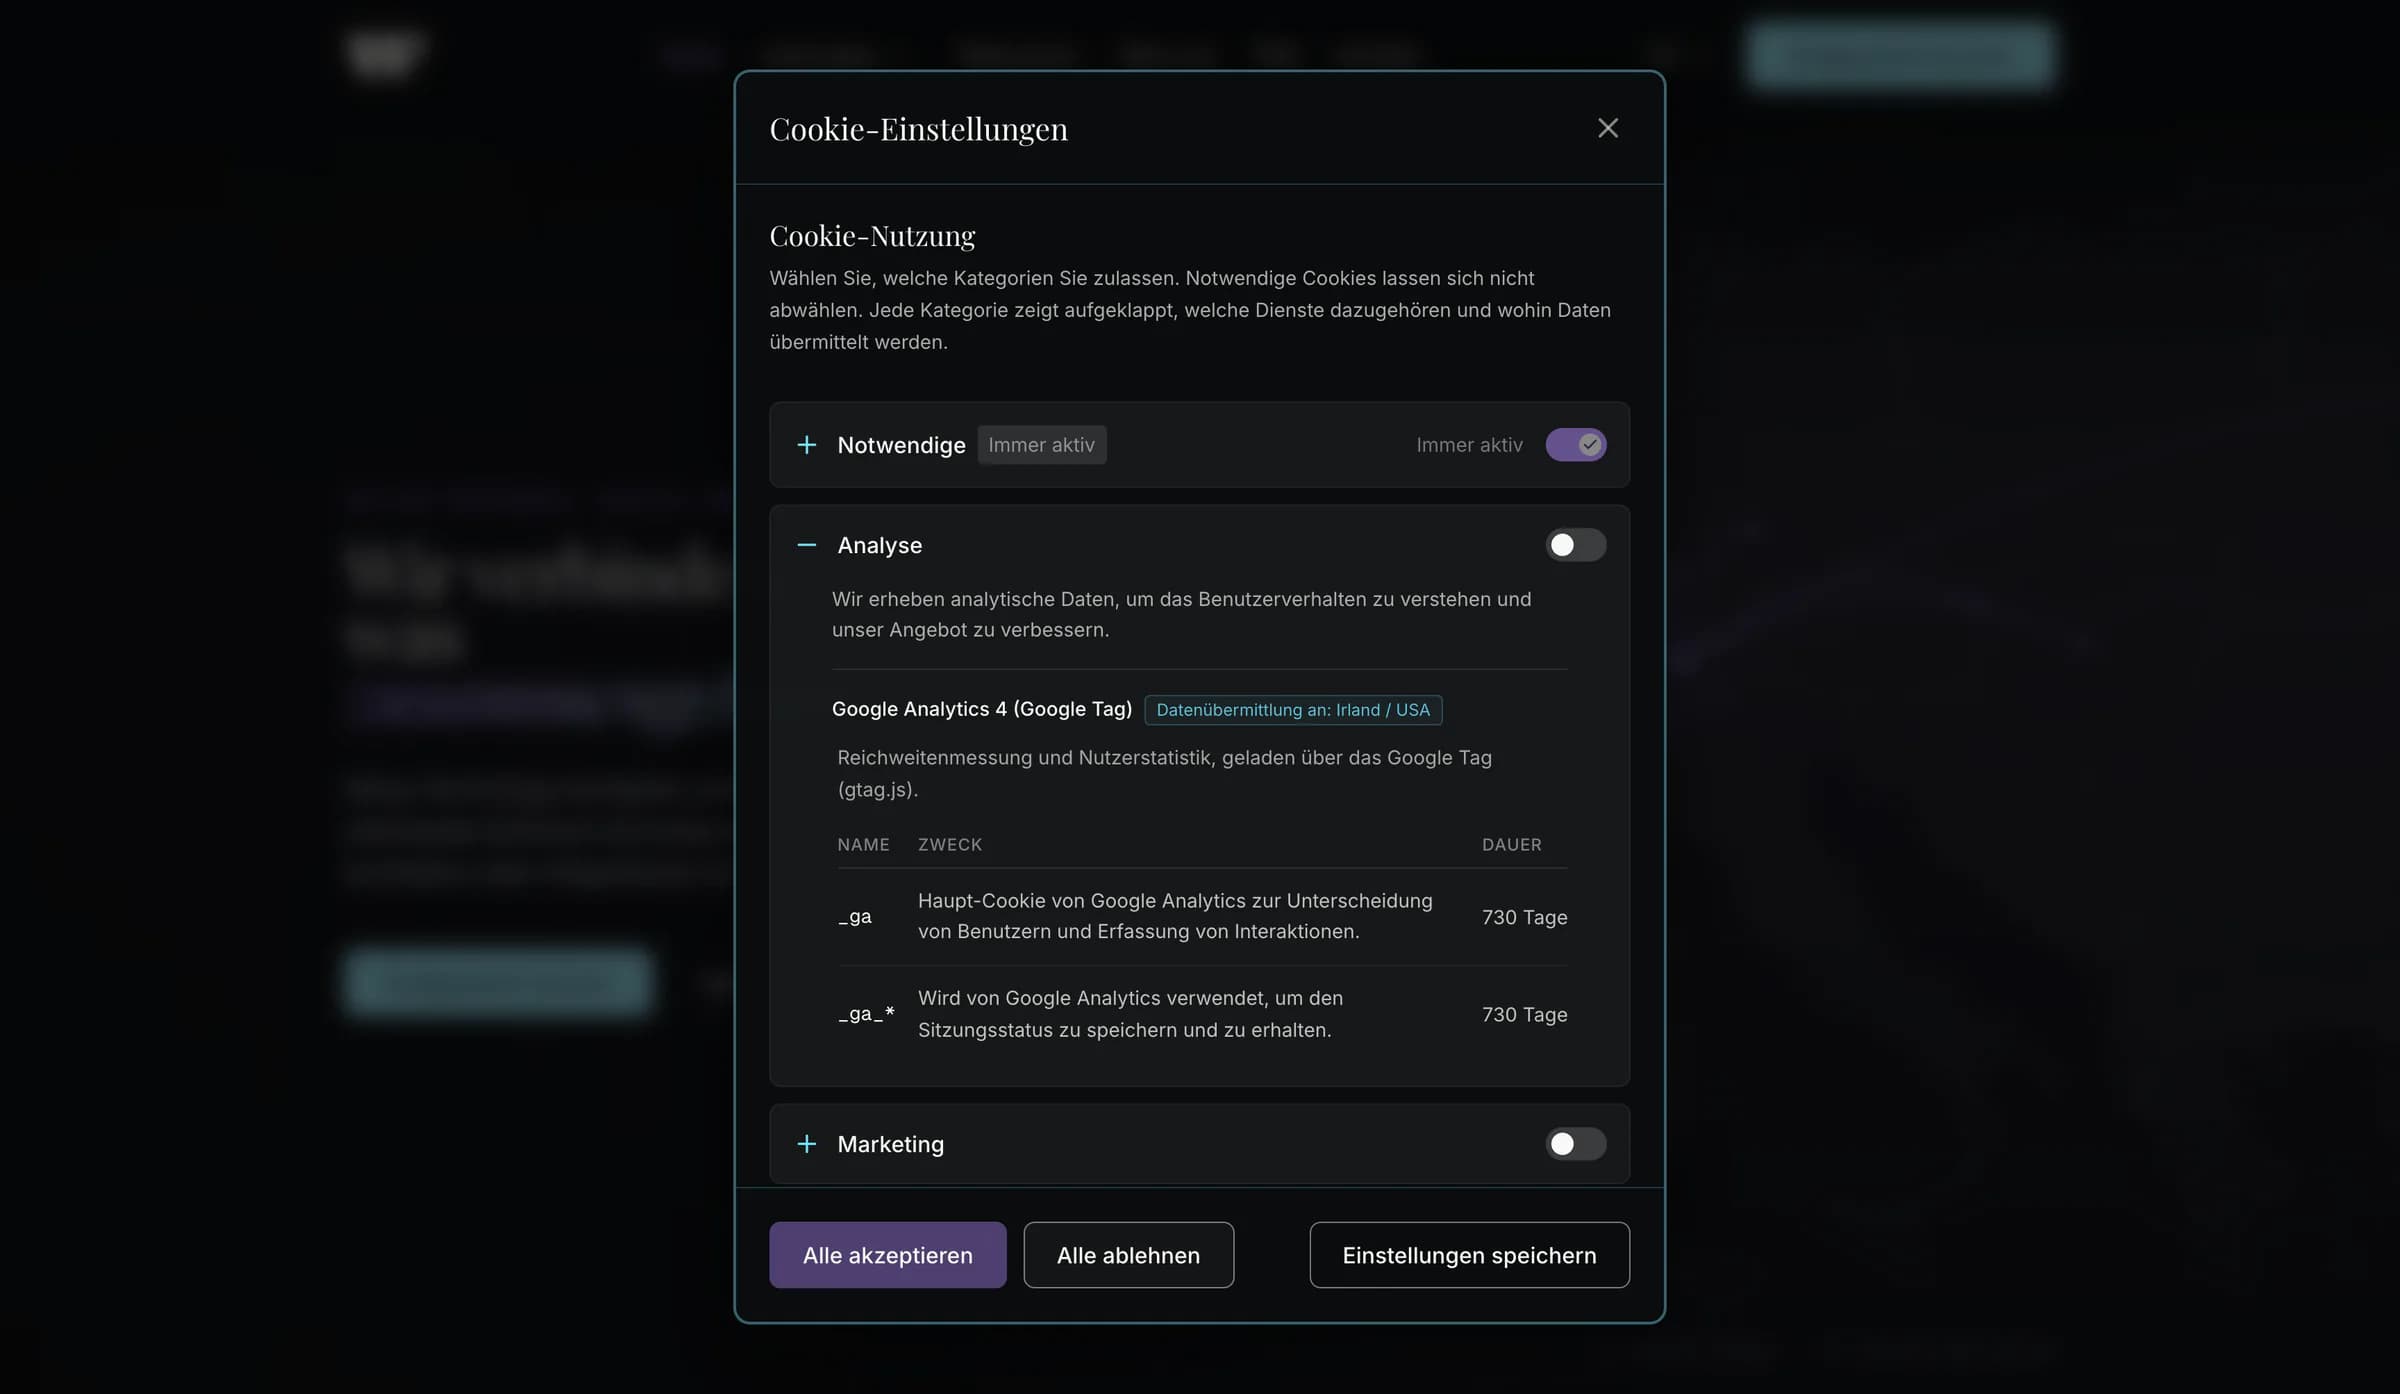
Die Engine bietet eine Standard-Oberfläche, die sich ganz oder teilweise durch projektspezifische Komponenten ersetzen lässt.
Ein Projekt kann- Banner und Einstellungsdialog unverändert übernehmen
- nur das Banner selbst gestalten
- nur den Einstellungsdialog ersetzen
- beide Oberflächen individuell umsetzen
Consent-State, Versionierung und Widerruf bleiben dabei zentral verwaltet.
Serverseitige Protokollierung von Entscheidungen
Jede Einwilligung und jede spätere Änderung erzeugt neben dem Zustand im Browser einen Datensatz auf dem Server. Diese Protokollierung ist fester Bestandteil des Ablaufs, keine Option.
Wohin der Datensatz geht, bestimmt auch hier die Implementierung der Schnittstelle: Standardmässig legt die Anwendung ihn als Datei auf dem eigenen Server ab. Ebenso kann sie ihn über eine API an einen anderen Dienst übergeben, der ihn etwa in einer Datenbank verwaltet.
- Consent-ID
- Konfigurationsversion
- getroffene Auswahl
- Zeitpunkt
- User-Agent
- gekürzte IP-Adresse
IPv4-Adressen werden nach dem zweiten Block gekürzt, IPv6-Adressen nach dem dritten Segment. Eingehende Einträge werden geprüft; unvollständige oder unzulässige Anfragen werden abgewiesen.
Die Protokollierung unterstützt die Nachvollziehbarkeit von Entscheidungen, stellt jedoch keine revisionssichere Archivierung dar.
Ein Fehler bei der Protokollierung blockiert die Anwendung nicht
Die Entscheidung des Besuchers wird zuerst im Consent-Zustand der Anwendung wirksam. Schlägt die serverseitige Speicherung fehl, bleibt die Website weiterhin nutzbar.
Der Fehler wird serverseitig protokolliert, statt technische Details im Browser offenzulegen. Damit hängt die Funktionsfähigkeit des Consent-Systems nicht davon ab, ob die Protokollierung in jedem Moment verfügbar ist.
Vom Klick zum Protokolleintrag
01 Einstellungen geladen02 Auswahl erhalten03 Consent-Zustand aktualisiert04 Entscheidung protokolliertAblauf abgeschlossen- 01
Auswahl im Banner
Der Besucher entscheidet je Kategorie, welche Dienste er zulässt. Notwendige Speicherwerte bleiben aktiv.
- 02
Umsetzung in der Anwendung
Die Engine speichert die Auswahl, aktualisiert Google Consent Mode und gibt zugelassene Dienste frei.
- 03
Protokoll auf dem Server
Die Entscheidung wird mit Version und Zeitpunkt protokolliert.
Warum die eigene Lösung für uns naheliegend war
Abhängigkeiten und laufende Kosten gar nicht erst entstehen zu lassen, war das Ziel. Dass sich das schnell und zuverlässig umsetzen liess, lag an dem, was wir bereits mitbrachten.
- Fachwissen zu Datenschutz und Consent
- Wie Einwilligungen, Google Consent Mode und die Informationspflichten gegenüber Besuchern zusammenspielen, gehört zu unserer täglichen Arbeit an Webanwendungen.
- Eigene Anwendungen statt Baukasten
- Unsere Projekte sind eigenständige Webanwendungen. Consent liess sich deshalb als Teil der Anwendung bauen, statt von aussen eingebunden zu werden.
- Eigene Infrastruktur
- Hosting, Deployment und Firewall betreiben wir selbst. Protokolle auf eigenen Servern brauchten deshalb keinen neuen Dienst, sondern einen Endpunkt mehr in der bestehenden Anwendung.
- Gemeinsame Bausteine
- Über unsere private Paketverwaltung teilen sich unsere Projekte bereits andere Bausteine. Die Consent-Engine ist einer davon und steht jedem neuen Projekt zur Verfügung.
Die Consent-Engine war damit keine Grossbaustelle, sondern eine Erweiterung dessen, was ohnehin vorhanden war.
Consent kann direkt in die Anwendung integriert werden
Der zentrale Consent-Zustand steht auch dem Anwendungscode zur Verfügung.
- Ist Analytics freigegeben?
- Darf ein eingebettetes Video geladen werden?
- Muss vor einer externen Karte zunächst eine Einwilligung eingeholt werden?
- Ist die gespeicherte Entscheidung für die aktuelle Consent-Version noch gültig?
Consent bleibt damit nicht auf Banner und Einstellungsdialog beschränkt, sondern kann direkt in den Ablauf einer Anwendung integriert werden.
Volle Kontrolle heisst volle Verantwortung
Wer keinen Anbieter hat, hat auch niemanden, der Cookie-Listen nachführt, Änderungen an Google Consent Mode übernimmt oder Texte an eine neue Rechtslage anpasst. Diese Arbeit liegt bei uns – als Teil der Pflege, die wir für unsere Anwendungen ohnehin leisten – oder beim Kunden, wenn Texte und Angaben über ein angebundenes CMS gepflegt werden.
Ein eigenes Fundament für Consent, ohne Anbieter dazwischen
Die Consent-Engine wird heute in unterschiedlichen Webanwendungen eingesetzt – ohne externen Anbieter, ohne laufende Lizenz und mit Einwilligungen und Protokollen auf eigener Infrastruktur. Zentrale Funktionen werden einmal gepflegt, während Daten, Integrationen, Sprachen und Oberfläche projektspezifisch bleiben.
- Unabhängigkeit
- Kein Anbieter, keine Lizenz, kein fremdes Script im Ladeweg.
- Datensouveränität
- Konfiguration, Einwilligungen und Protokolle liegen auf eigener Infrastruktur.
- Consent vor zustimmungspflichtigen Diensten
- Entsprechende Integrationen werden erst nach der erforderlichen Einwilligung geladen.
- Versionierte Entscheidungen
- Gespeicherte Einwilligungen sind an den jeweiligen Stand der Consent-Konfiguration gebunden.
- Zentrale Consent-Logik
- State, Versionierung, Registry, Script-Gating und Widerruf werden gemeinsam verwaltet.
- Wiederverwendbar und flexibel
- Datenquellen, Sprachen und Oberflächen je Projekt; Verbesserungen an der Engine über versionierte Updates.
Möchten Sie selbst bestimmen, wohin die Daten Ihrer Besucher gehen?
Im Erstgespräch klären wir, welche Dienste auf Ihrer Website Daten an Dritte übertragen, wo sich datensparsame Alternativen anbieten und wie Einwilligungen und Protokolle dort bleiben, wo Ihre Anwendung läuft.